
AIT vs Git worktree · 游戏开发 benchmark
同一个 coding agent、同一款游戏任务、两种仓库工作流。
我们让全新的 GPT-5.6 Sol agent 维护同一款浏览器游戏、完成相同任务。 一边使用 AIT Task 与隔离 worktree,另一边使用传统 Git linked worktree; 然后比较两边做到“通过独立功能验收”各需要多少 provider token。
- 5 个具体游戏开发任务
- 每个任务 20 组有效配对
- 每次 campaign:AIT 100 + Git 100
- GPT-5.6 Sol · max reasoning
实测结果
两次完整 campaign 都测到 AIT 约少用三分之一 token。
范围:五个游戏任务与固定模型。两次实验分别分析,失败与替补均有披露;有效验收结果包含获准替补的执行。Token 用量不是美元费用估算,这些实验也未测量高并发吞吐量。
主要指标让五个 workload 权重相同;provider 原始总量只作描述性交叉检查,不替代 workload 平衡结果。
| Campaign | Workflow | Token 节省 | 95% CI | Provider 原始总量 | 时间节省 | 证据历史 |
|---|---|---|---|---|---|---|
| 已发布 baseline | Sprint off | 34.95% | 27.85–39.77% | AIT 46,300,272 / Git 70,140,925 低 33.99% | 21.04% | 运行 201 / 有效 200 |
| 自然检查 replication | Sprint on | 36.28% | 28.26–41.83% | AIT 45,432,262 / Git 71,238,660 低 36.23% | 15.22% | 运行 203 / 有效 200 |
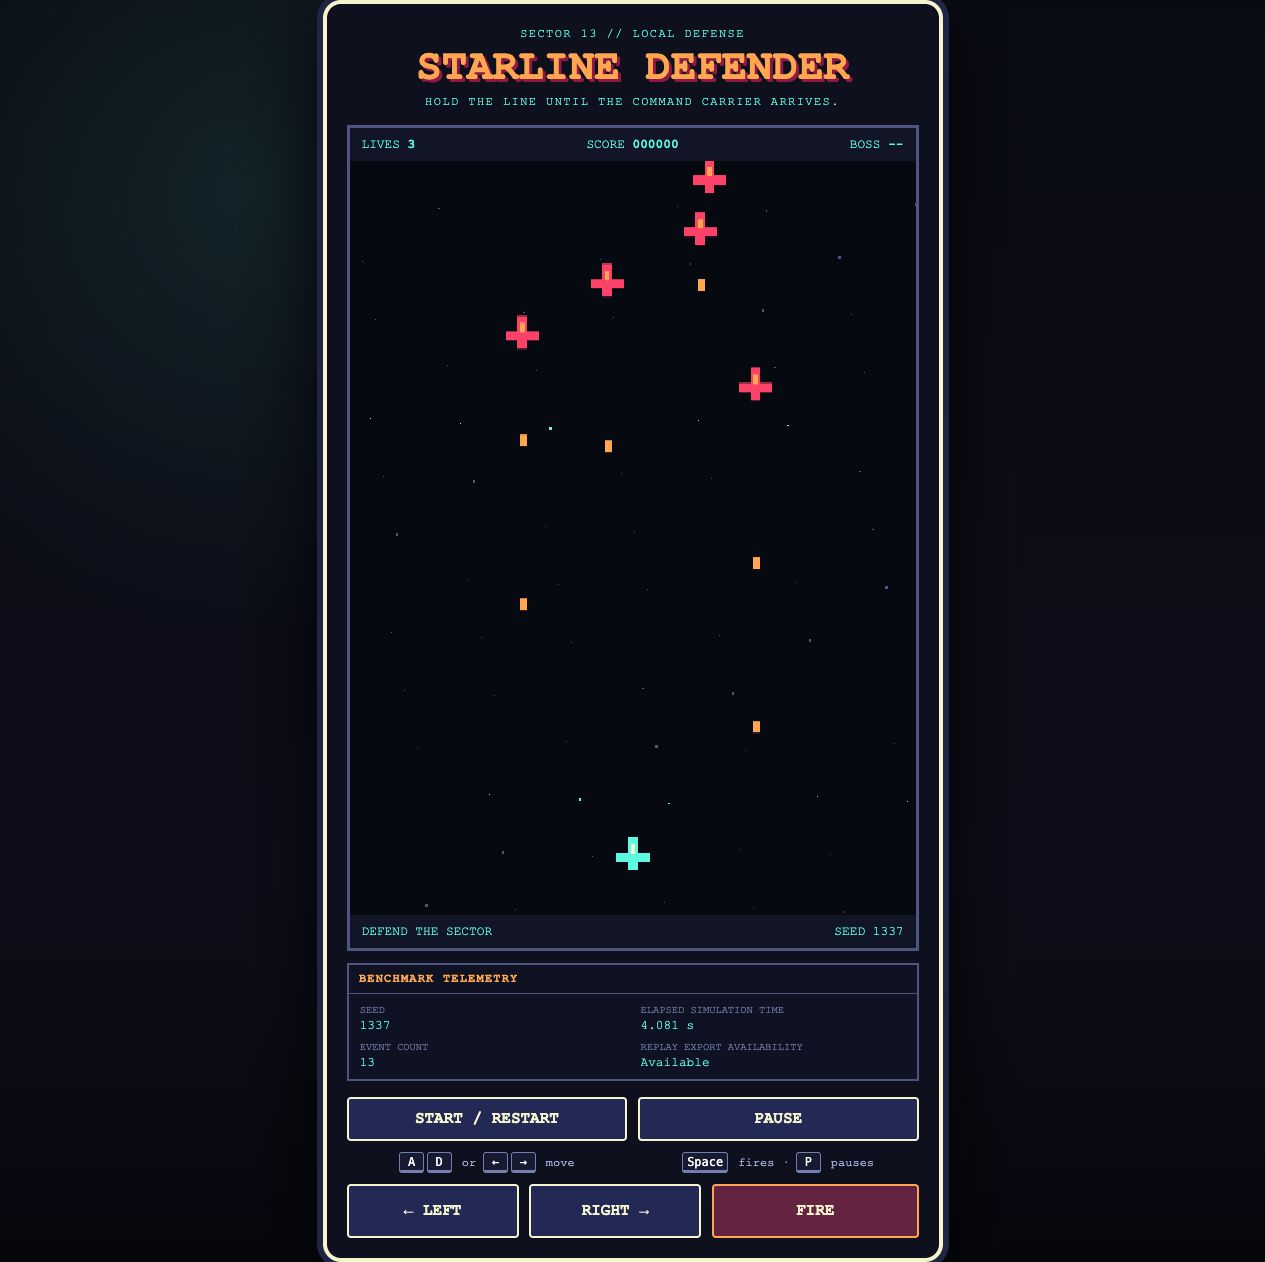
…b004-gd-05-ait;不是生成图片,也不是另外制作的 mockup。
Agent 到底在改什么
一款现成、可复现的浏览器射击游戏。
测试 fixture 是不依赖第三方包的 JavaScript 游戏 Starline Defender。它原本就有移动、敌人、计分、暂停、 replay、设置、键盘控制和回归测试接口。所以这里测量的是维护已有代码、 修 bug、加功能和重构,不是让 agent 从零生成一款游戏。
可玩页面直接发布其中一个 100/100 通过的 AIT session 公开网页文件, 让你亲自理解 evaluator 检查的产物。它只用于展示产物类型;下方统计 使用所有有效 session,不是拿这一个案例计算或挑最好看的结果。
五个 workload
从单一回归修复,一直增加到 beta 发布准备。
每个 session 只会收到以下一份冻结任务规格,以及相同的验收契约;任务规模有意逐步增大。
阻止子弹异常连发
修复射击回归,确保已有的 180 ms firing cooldown 确实生效,同时不能破坏正常游玩。
加入需要两次命中的装甲敌人
外观必须容易识别、命中两次才会摧毁,而且击破时必须正好得到 250 分。
修复暂停/继续后的 replay 分歧
暂停期间必须冻结时间和输入,使录制的 replay 在继续后仍收敛到相同最终状态。
安全拆分单体 game.js
提取 model、renderer 和 input 模块,同时保持原有游戏行为和 public API 不变。
完成可发布的 beta 产物
加入带版本的 replay、设置规范化、移动端输入、focus recovery、benchmark panel、release check 和文档,而且不能新增 dependency 或对外联网。
一组配对怎样运行
同一个任务运行两次,只有仓库 workflow 不同。
- 从完全相同的 bytes 开始。AIT 和 Git lane 收到相同 fixture、任务文字、模型 revision、reasoning effort 和验证命令。
- 各开一个全新 agent session。每个 lane 都是新的 GPT-5.6 Sol max session 和独立 workspace,不会沿用上一次对话。
- 应用一种 workflow treatment。AIT lane 使用 AIT Task lifecycle;Git lane 使用 temporary branch 和 linked worktree。
- 让 agent 自然完成工作。两边都可以读文件、修改、测试,并在有意义时使用 status 或 diff;prompt 不强制,也不禁止。
- 由独立 evaluator 验收产物。Harness 运行冻结的功能检查并评分;只完成 workflow、但游戏损坏,不能算通过。
- 计入完整 provider usage。有效 session 的机器可读 provider token 总量和耗时,才进入配对分析。
AIT treatment
Task + 隔离 worktree
Agent 启动 AIT Task,在绑定的 worktree 工作,可以创建中间 Snapshot,最后通过 Task closeout 完成。Baseline 关闭 sprint mode;replication 绑定一张精确 sprint card。
Git treatment
Linked worktree + temporary branch
Agent 在 temporary branch 的 Git linked worktree 内工作、提交结果、集成回干净的 target branch,最后移除临时 worktree 和 branch。
200 个 session 怎样组成
重复运行配对,测出变异,而不是只比较两个个例。
5 个 workload×20 组配对×2 种 workflow=200 个 session
每个 workload 纳入 20 组 AIT/Git 配对,所以每次 campaign 都是 100 个 AIT 加 100 个 Git 有效 session。完整设计运行两次,而且分开分析。已发布 baseline 共运行 201 个原始 session,形成 200-session 有效视图;replication 共运行 203 个原始 session,形成另一份 200-session 有效视图。所有排除和 replacement 都在后面逐项披露。
数字代表什么
先确认功能通过,再比较 provider 成本,并呈现不确定性。
有效验收
冻结 evaluator 会检查启动、必要功能、确定性、分数门槛、workflow closeout,以及不得使用外部 dependency 或 network。每次 campaign 的两边有效验收都是 100/100。
Provider token
成本取自每个有效 agent session 的 provider 机器可读 total-token usage,不是用命令数量或最终 patch 大小推算。
Workload 平衡节省
先在五个 workload 各自计算 AIT 的相对 token 节省,再取中位数,避免最大的 GD-05 单独主导 headline。
95% 置信区间怎样解读
分析在每个 workload 内对观察到的 20 组配对重采样 2,000 次,每次重算 workload 平衡后的节省,再取 bootstrap 结果中间 95%。如果区间跨过零,就说明方向仍不确定;两次 campaign 和每个 workload 的区间都高于零。这个区间描述此测试设计的采样不确定性,不代表每个 repository 或任务都一定能节省同样比例。
逐任务结果
两次 campaign 的每个 workload 都偏向 AIT。
已发布的 1.1.0 sprint-off baseline
| Workload | AIT 有效 token | Git 有效 token | Token 节省 | 95% CI | 配对 |
|---|---|---|---|---|---|
| GD-01 | 213,481.0 | 317,517.8 | 32.77% | 22.07–41.92% | 20/20 |
| GD-02 | 266,652.6 | 428,522.2 | 37.77% | 27.59–45.66% | 20/20 |
| GD-03 | 376,821.3 | 496,364.8 | 24.08% | 12.41–34.32% | 20/20 |
| GD-04 | 580,373.9 | 915,416.8 | 36.60% | 25.68–45.84% | 20/20 |
| GD-05 | 877,684.7 | 1,349,224.8 | 34.95% | 22.36–44.82% | 20/20 |
Sprint-on 自然检查 replication
| Workload | AIT 有效 token | Git 有效 token | Token 节省 | 95% CI | 配对 |
|---|---|---|---|---|---|
| GD-01 | 254,455.2 | 363,422.4 | 29.98% | 15.11–41.62% | 20/20 |
| GD-02 | 286,894.6 | 454,931.1 | 36.94% | 26.82–46.31% | 20/20 |
| GD-03 | 355,256.8 | 557,551.1 | 36.28% | 22.92–47.19% | 20/20 |
| GD-04 | 636,606.8 | 904,065.0 | 29.58% | 21.19–37.73% | 20/20 |
| GD-05 | 738,399.7 | 1,281,963.4 | 42.40% | 34.53–49.32% | 20/20 |
在各自的冻结分析中,两次 campaign 的每个 workload 区间都高于零。
运行历史
功能失败和主机中断都保留在公开记录中。
Baseline:运行 201 个 session,形成 200 个有效 session
原始 AIT GD-05 没有保留 soundEnabled: 0,因此未通过冻结功能检查。该结果保留在 ledger,按披露的同 pin 政策只 replacement 一次;只有通过的 replacement 进入有效视图。
Replication:运行 203 个 session,形成 200 个有效 session
三个来源运行被排除并披露:一个受 executor infrastructure failure 污染的 GD-02 Git lane;一个在 terminal summary 生成前被主机关机中断的 GD-05 Git lane;以及一个只获准 replacement 一次的有效 GD-05 AIT 功能失败。Infrastructure 和关机案例采用 whole-pair recovery。另一个 recovered-spawn 分类通过 digest-linked adjudication 修正,没有重跑该 session。
公开记录保留 source_protocol_claim_eligible=false。Current policy revision game-development-2026-08-29.36 另行记录 criteria 已满足,并得到有效 claim_eligible=true;旧标记没有被删除。
解读边界
对这组任务是强证据,但不是普遍定律。
两次 campaign 共同支持
在这五个 fixture 和模型 pin 下,两次分开分析都显示 AIT 的 provider token 约低三分之一,同时保持相同的有效功能验收。
这个比较不能证明
两次 campaign 的 workflow mode、prompt、AIT binary、seed、日期和 recovery history 不同;样本没有合并,也不是 sprint-on/off 的因果 A/B test。结果不保证适用于每个 codebase、model 或 task,线性 session 也没有测量 high-concurrency throughput。
审计证据
每次 campaign 都有自己的不可变摘要、JSON、ledger 和 checksum。
已发布的 1.1.0 baseline
summary.txtBaseline 的可读结果、方法和披露。
result.jsonBaseline 的机器可读整体和 workload 结果。
runs.jsonBaseline 的 session 纳入、时间和 token ledger。
SHA256SUMS已发布 baseline 集合的完整性 hash。
Sprint-on 自然检查 replication
结论
在这五个游戏开发任务中,AIT 相比 Git worktree 约少用三分之一 provider token,而且完成相同的验收结果。
两次分开分析的 campaign 分别测到 34.95% 节省(95% CI 27.85–39.77%)和 36.28% 节省(95% CI 28.26–41.83%)。每个 workload 都偏向 AIT,两边有效验收都是 100/100,而且两个整体区间都高于零。